AI与大数据融合 机遇、挑战与未来责任——以人工智能基础软件开发为视角
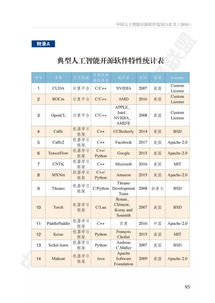
引言\n\n人工智能(AI)与大数据的融合正在重塑技术革命的底层逻辑。数据是AI的燃料,算力是引擎,而人工智能基础软件则是连接燃料与引擎的控制系统。在这场融合浪潮中,基础软件开发既是机遇的承载者,也是挑战的集中地,更关乎未来技术伦理与责任的落地。\n\n## 一、融合的机遇:基础软件层的重新定义\n\n### 1. 从工具到基础设施的跨越\n传统大数据栈(存储、计算、分析)与AI框架(训练、推理、部署)的边界日益模糊。基础软件开发者有机会构建统一的数据-AI融合平台,如支持流批一体的特征工程引擎、分布式训练调度器、模型即服务(MaaS)框架等,大幅降低企业智能化门槛。\n\n### 2. 软硬件协同的架构红利\n随着GPU、NPU、DPU等异构算力普及,基础软件可以通过编译器优化、统一内存管理、自动算子融合等方式,释放硬件潜能。大数据场景下的实时推理与增量学习,将催生新的基础软件栈——例如向量数据库与关系型数据库的原生融合、流式训练框架等。\n\n### 3. 开源生态与商业化空间\nPyTorch、TensorFlow、Ray等已成为AI基础软件的事实标准。创业公司在数据编排、模型编译、Agent框架等细分赛道仍有机会。大模型时代,“数据-训练-部署-反馈”的闭环进一步提供可观测性、安全网关、成本调度等基础软件缺口。\n\n## 二、核心挑战:从工程到系统的现实困境\n\n### 1. 数据规模与质量的悖论\n大数据“量大质低”,标注成本高昂,而基础软件需要在不完美数据上保证训练稳定性与效率。分布式数据清洗、弱监督学习支持、数据版本管理与血缘追踪等,对系统设计提出高要求。\n\n### 2. 算力与效率的瓶颈\n大模型参数规模指数增长,而硬件增长放缓。基础软件必须在通信优化、显存复用、混合精度、算子融合等方面深挖。在推理侧,长上下文、多模态、动态批处理等场景下,PagedAttention等工作展示了基础软件的决定性作用。\n\n### 3. 异构与碎片化锁死\n企业往往拥有多种数据源与算力设备(X86、ARM、国产芯片、云边端)。AI基础软件开发需要抽象硬件差异,但过度抽象会牺牲性能。如何构建可移植且高效的中介层(如MLIR、OpenXLA)是长期挑战。\n\n### 4. 安全、隐私与治理内生化\n数据跨域融合时,隐私泄露与合规风险剧增。基础软件需支持联邦学习、安全多方计算、可信执行环境等原生机制。可靠性与可解释性应成为基础库的一等公民。\n\n## 三、未来责任:基础software开发者的伦理与治理担当\n\n### 1. 主动设计“易问责”的基础设施\nAI基础软件不应仅追求性能,还需嵌入审计日志、透明度接口、模型拒绝采样机制。开发者应推动可追溯的数据流与模型谱系,确保伦理要求落到编译与运行层面。\n\n### 2. 能耗与可持续性\n训练千亿级模型碳排放惊人。基础软件可通过编辑调度、稀疏化支持、节能调度类库来引导行业迈向绿色AI。这已是从业者的道德责任。\n\n### 3. 公平可及与避免垄断\nAI基础软件若被少数巨头封闭把控,将加大数字鸿沟。开源社区应与学术机构、政府协作,通过文档本地化、低耗硬件支持、教育套件等方式,让更多地区参与创新。\n\n###
如若转载,请注明出处:http://www.cxwjq.com/product/47.html
更新时间:2026-09-19 03:29:14